Red neuronal prealimentada
SCIENTIA NON HABET HOSTEM NISI IGNORANTEM: «La ciencia no tiene más enemigo que el ignorante.»
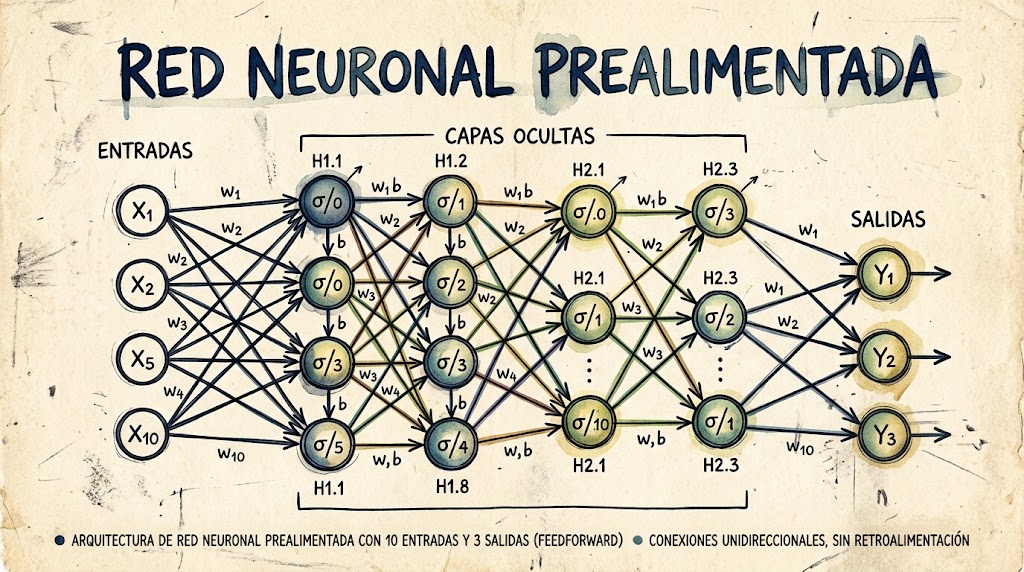
En un artículo anterior desgranamos la anatomía de GLM‑5.2 y explicamos cómo una red neuronal prealimentada expande vectores de 12.288 a 49.152 dimensiones para encontrar patrones en los datos.
Ahora presentamos un ejemplo completo con datos de análisis clínicos de una población de 10.000 pacientes para predecir el riesgo de enfermar. Acompañamos el proceso paso a paso, con números, tablas y la lógica matemática que convierte una consulta médica en una probabilidad. (Nota: Este modelo es una arquitectura pedagógica simplificada. Un sistema clínico real requeriría un preprocesamiento de datos temporal más complejo y validación externa estricta, pero la lógica de expansión dimensional que aquí ilustramos sería idéntica).
1. El problema
Disponemos de una cohorte de 10.000 pacientes. Cada uno se describe mediante 10 características clínicas (edad, IMC, glucosa, HbA1c, triglicéridos, HDL, presión sistólica, perímetro abdominal, antecedentes familiares y actividad física). Todas ellas se normalizan entre 0 y 1 para que la red converja más rápido.
| Variable | Rango real | Valor normalizado (ejemplo) |
|---|---|---|
| Edad | 20‑80 años | 0.75 |
| IMC | 18‑45 kg/m² | 0.85 |
| Glucosa en ayunas | 70‑200 mg/dL | 0.80 |
| HbA1c | 4.5‑12 % | 0.85 |
| Triglicéridos | 50‑400 mg/dL | 0.70 |
| Colesterol HDL | 20‑80 mg/dL | 0.25 |
| Presión arterial sistólica | 100‑180 mmHg | 0.80 |
| Perímetro abdominal | 70‑130 cm | 0.88 |
| Antecedentes familiares (sí/no) | 0/1 | 1.00 |
| Actividad física (h/sem) | 0‑10 h | 0.10 |
La etiqueta que queremos predecir es binaria: 1 si el paciente desarrolla diabetes tipo 2 en los próximos 5 años, 0 en caso contrario.
2. Arquitectura de la red
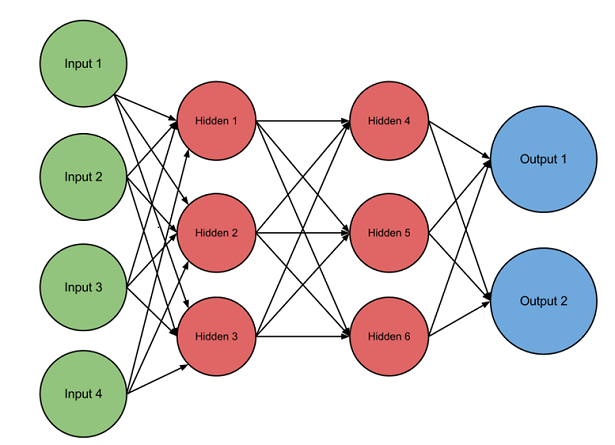 Diseñamos una red prealimentada con tres capas ocultas:
- Capa de entrada: 10 neuronas (una por variable).
- Capa oculta 1: 512 neuronas con activación ReLU.
- Capa oculta 2: 1.024 neuronas — aquí ocurre la expansión masiva.
- Capa de salida: 1 neurona con activación sigmoide (probabilidad de riesgo).
3. ¿Cómo se dimensionan las capas?
El número de neuronas por capa no es arbitrario. Existen reglas empíricas y fundamentos matemáticos que guían estas decisiones:
3.1 Regla de oro: entre el tamaño de entrada y el de salida
Un enfoque clásico es que el tamaño de las capas ocultas se sitúe entre el número de neuronas de entrada y el de salida. En nuestro caso, entre 10 y 1. Además, se suele usar una progresión geométrica o piramidal: las capas crecen o decrecen de forma gradual.
Para nuestro problema: (10 + 1) × 2/3 ≈ 7,3. Sin embargo, estas reglas clásicas están diseñadas para problemas de baja dimensionalidad. En datos clínicos tabulares con alta colinealidad (por ejemplo, el IMC y el perímetro abdominal comparten información redundante), las reglas estándar subestiman la capacidad necesaria. Por ello, en la práctica moderna se usan heurísticas basadas en la complejidad del dataset, empezando en potencias de 2 (como 512) para permitir que la red despliegue su capacidad de procesamiento no lineal.
3.2 La regla del 2×
Una práctica común es que cada capa oculta tenga el doble de neuronas que la anterior. Así:
- Capa 1: 10 × 2 = 20 (demasiado pequeña para nuestro problema).
- En su lugar, partimos de 512 y duplicamos a 1.024 para forzar la expansión.
3.3 El teorema de aproximación universal
Este teorema establece que una red con una sola capa oculta puede aproximar cualquier función continua, siempre que tenga suficientes neuronas. El problema es que «suficientes» puede ser un número astronómico. La solución práctica es apilar varias capas (deep learning) para que cada capa aprende representaciones jerárquicas:
- Capa 1 (512): Aprende a separar combinaciones simples (ej. valores de glucosa aislados o IMC elevado).
- Capa 2 (1.024): Combina esas separaciones básicas en espacios de mayor dimensión (ej. la intersección matemática de glucosa alta e IMC bajo).
3.4 Evitar el sobreajuste
Demasiadas neuronas pueden memorizar los datos de entrenamiento en lugar de generalizar. Para evitarlo:
- Usamos regularización L2 (penalización por pesos grandes).
- Añadimos dropout (apagamos aleatoriamente el 20‑30% de las neuronas durante el entrenamiento).
- Empleamos early stopping (detenemos el entrenamiento cuando el error en validación comienza a subir).
4. El viaje de un paciente por la red
Tomamos a un paciente con los valores normalizados de la tabla anterior (edad 0.75, IMC 0.85, glucosa 0.80, HbA1c 0.85, triglicéridos 0.70, HDL 0.25, presión 0.80, perímetro 0.88, antecedentes 1.00, actividad 0.10). Seguimos su avance.
4.1 Capa de entrada
Los 10 números entran sin modificaciones: [0.75, 0.85, 0.80, 0.85, 0.70, 0.25, 0.80, 0.88, 1.00, 0.10].
4.2 Capa oculta 1
Cada neurona j calcula:
y luego aplica ReLU: hj = max(0, zj). Este paso inicial ya implica 5.120 pesos (10 entradas × 512 neuronas) y 512 sesgos, lo que proporciona el primer salto cualitativo al proyectar los datos de un espacio de 10 dimensiones a uno de 512. El resultado es un vector de 512 números, algunos cercanos a cero (no activados) y otros positivos.
4.3 Capa oculta 2
Cada neurona k recibe todas las 512 salidas de la capa anterior:
Este paso convierte los 512 valores en 1.024 nuevas representaciones. Es como si la red proyectara los datos en 1.024 ejes diferentes.
| Neurona | Activación (valor) | Correlación estadística aproximada |
|---|---|---|
| #342 | 0.92 | Se activa fuertemente ante valores que, en lenguaje clínico, asociaríamos a glucosa alta combinada con HDL bajo y edad avanzada. |
| #871 | 0.88 | Responde a la combinación matemática de IMC alto, antecedentes positivos y baja actividad física. |
| #115 | 0.76 | Se activa frente a triglicéridos elevados y perímetro abdominal grande, independientemente de otros factores. |
| #203 | 0.05 | No se activa (valores normales en las variables que pondera esta neurona específica). |
| … | … | … |
4.4 Capa de salida
Las 1.024 activaciones se combinan linealmente y pasan por una función sigmoide:
El resultado es un número entre 0 y 1. Para nuestro paciente, la salida es 0.94 (riesgo muy alto).
5. ¿Cómo entrena la red y descubre patrones?
El entrenamiento es el corazón del proceso. Con 10.000 pacientes etiquetados, la red ajusta sus millones de parámetros para minimizar el error. El algoritmo estrella es la retropropagación (backpropagation) combinada con descenso de gradiente.
- Inicialización: todos los pesos y sesgos se asignan con valores aleatorios pequeños.
- Propagación hacia adelante: se introducen los pacientes de uno en uno y se calcula la predicción.
- Error: se compara la predicción con la etiqueta real usando binary cross‑entropy.
- Retropropagación: se calcula la contribución de cada peso al error total mediante la regla de la cadena.
- Actualización: se ajustan todos los pesos en la dirección que reduce el error (gradiente descendente).
- Se repite el ciclo durante decenas de épocas hasta que el error se estabiliza.
🧠 Correlaciones multidimensionales que ajusta la red:
- Intersecciones complejas: El descenso de gradiente asigna pesos mayores a combinaciones simultáneas (ej. HbA1c > 7.0 + triglicéridos > 200) que a cada variable aislada.
- Relaciones no lineales: Los pesos se ajustan para reflejar que el riesgo no aumenta de forma lineal, sino que se acelera a partir de ciertos umbrales de edad.
- Interacciones estadísticas: El algoritmo modifica los pesos de forma que el valor de la falta de ejercicio modifica su impacto proporcionalmente si el peso asociado a «antecedentes familiares» está activo.
6. Diagnóstico de varias enfermedades
 Hasta ahora hemos visto cómo la red predice una sola patología (diabetes tipo 2). Pero en la práctica clínica, un paciente puede presentar múltiples enfermedades simultáneamente. Veamos cómo se adapta la arquitectura para este escenario.
6.1 Cambios en la arquitectura
Para detectar varias enfermedades, la red necesita modificar su capa de salida:
- Capa de salida múltiple: en lugar de 1 neurona, tendremos N neuronas, donde N es el número de enfermedades a detectar.
- Función de activación: se usa sigmoides múltiples (una por enfermedad) o softmax si las enfermedades son mutuamente excluyentes.
- Función de pérdida: se emplea binary cross-entropy para cada enfermedad (etiquetado multi-label).
6.2 El viaje de un paciente con múltiples patologías
El proceso es idéntico hasta la capa oculta 2 (1.024 neuronas). La diferencia está en la capa de salida:
Para la hipertensión y la dislipidemia, la estructura matemática es exactamente la misma. La única diferencia es que la capa de salida utiliza su propio conjunto de pesos y sesgos específicos para esa patología concreta, permitiendo que la misma red aprenda combinaciones de patrones distintas para cada enfermedad.
6.3 Resultados para múltiples enfermedades
Mostramos dos casos con la predicción para tres enfermedades simultáneas. Estos resultados estadísticos deberán ser validados por una Doctora, quien sumará a esta probabilidad matemática su conocimiento clínico y el contexto integral del paciente.
👨 Juan
HTA: 0.89
Dislipidemia: 0.92
👩 María
HTA: 0.08
Dislipidemia: 0.15
7. ¿Por qué funciona la expansión a miles de neuronas?
 El salto de 10 a 1.024 dimensiones no es un capricho arquitectónico ni una simple escala de potencia bruta. Responde a una necesidad geométrica fundamental para resolver problemas no lineales.
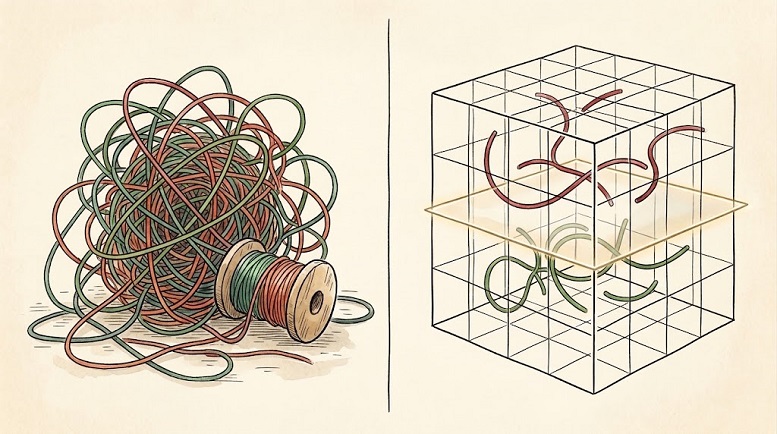
El problema de la baja dimensión: El ovillo de hilos
Imagina que nuestros 10.000 pacientes están representados en un espacio de 10 dimensiones (uno por cada variable clínica). Si quisiéramos separar a los «enfermos» de los «sanos» usando una sola línea recta (lo que matemáticamente se llama un hiperplano), fracasaríamos.
Los datos están entrelazados: un paciente con IMC normal pero con glucosa alterada puede estar enfermo, mientras que otro con IMC alto pero muy activo puede estar sano. En un espacio de 10 dimensiones, los puntos azules (enfermos) y verdes (sanos) forman un ovillo inseparable. Una red pequeña (10 → 10 → 1) actúa como un perceptrón simple, incapaz de trazar una línea recta que separe ese caos (es el mismo motivo por el que un perceptrón no puede resolver el problema lógico XOR).
La solución: Desenredar en alta dimensión
Aquí es donde entra la expansión a 1.024 neuronas. Las funciones de activación no lineales (como ReLU) no solo «apagan» números negativos; geométricamente, tuercen y curvan el espacio.
Al proyectar los datos originales a través de miles de pesos y aplicar ReLU, la red toma ese «ovillo» de 10 dimensiones y lo estira, lo pliega y lo «desenreda» en un espacio de 1.024 dimensiones. En este nuevo espacio gigantesco, la magia ocurre: los puntos que antes estaban mezclados quedan alineados de tal forma que las clases se vuelven linealmente separables.
El Teorema de Cover en acción
Este fenómeno está respaldado por el Teorema de Cover (1965), un resultado fundamental en la teoría de la información. El teorema demuestra matemáticamente que, al proyectar datos no linealmente en un espacio de dimensiones suficientemente alto, la probabilidad de que puedas separar dos clases con un simple hiperplano tiende a 1 (es decir, al 100%).
El truco de la última capa
En esencia, las capas ocultas masivas (512 y 1.024) hacen el trabajo más difícil: transforman las 10 coordenadas clínicas originales en 1.024 «coordenadas transformadas» donde la frontera entre enfermar y no enfermar ya es una línea recta clara. Por eso, la capa de salida (la función sigmoide) es tan simple: solo tiene que trazar ese hiperplano de decisión final sobre un espacio que ya ha sido ordenado por las capas anteriores.
El ejemplo de la diabetes tipo 2 ilustra que el poder predictivo no está en los parámetros individuales, sino en la combinación geométrica de millones de pesos entrenados. Cada neurona de la capa intermedia actúa como un eje de proyección específico que ayuda a separar el ovillo, y la última capa solo tiene que hacer el corte final.
8. Repaso: ¿Cómo aprende la red de los pacientes?
PASO 0: LOS PARÁMETROS
Antes de aprender, la red tiene números aleatorios llamados Pesos (W) y Sesgos (b). Son como los dialectos o interruptores de una consola de sonido: al principio están en posiciones aleatorias.
El objetivo del entrenamiento es mover esos interruptores con precisión milimétrica hasta encontrar la combinación exacta que haga que la «música» (la predicción de riesgo) suene perfecta.
Ejemplo visual: Si la red quiere distinguir a pacientes sanos de aquellos que desarrollarán diabetes, ajustará un peso para «vigilar la glucosa elevada» y otro para «medir los antecedentes familiares». ¡Cada ajuste acerca más a la predicción clínica correcta!
PASO 1: HACIA ADELANTE (FORWARD)
1. Entrada: Los 10 valores clínicos del paciente entran a la red.
2. Cálculo lineal (z): Cada capa multiplica los datos por los pesos (W) y suma el sesgo (b).
3. Activación (σ): Se aplica un filtro matemático (como ReLU) para decidir qué pasa a la siguiente capa.
4. Pérdida (L): Al final, comparamos la predicción (ej. 0.94) con la etiqueta real (enfermo) para medir el error.
PASO 2 Y 3: APRENDER DEL ERROR
Paso 2 (Atrás): Tomamos la Pérdida (L) y la enviamos de regreso por toda la red (flechas rojas). Calculamos los Gradientes, que son como un «GPS del error clínico»: nos dicen exactamente en qué dirección y cuánto debemos mover cada interruptor para que el error disminuya.
Paso 3 (Actualizar): El Optimizador usa ese GPS para mover un poquito los diales (W y b) en la dirección correcta, usando una tasa de aprendizaje (η) para no dar pasos demasiado bruscos.
PROPAGACIÓN HACIA ADELANTE (CÓMO PREDICE LA RED)
10 vars.
→
CAPA 1 (512)
→
CAPA 2 (1024)
→
CAPA SALIDA (1)
→
→
Comparar con paciente
PÉRDIDA (L)
PROPAGACIÓN HACIA ATRÁS (CORREGIR EL DIAGNÓSTICO)
←
←
CAPA SALIDA
←
CAPA 2 (1024)
←
CAPA 1 (512)
←
←
Comparte, tus amig@s lo agradecerán…
🐘 Mastodon: @LQSomos | 🗣️ Friendica: Loquesomos | 📱 UpScrolled: @LQSomos
💬 Telegram: LoQueSomosWeb | 🦋 Bluesky: LQSomos |
📘 Facebook: LoQueSomos | 📸 Instagram: LoqueSomos | 📲 WhatsApp: LoqueSomos
▶️ YouTube: @LoquesomosAudiovisual